AI资讯新闻榜单内容搜索-LLM

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: LLM
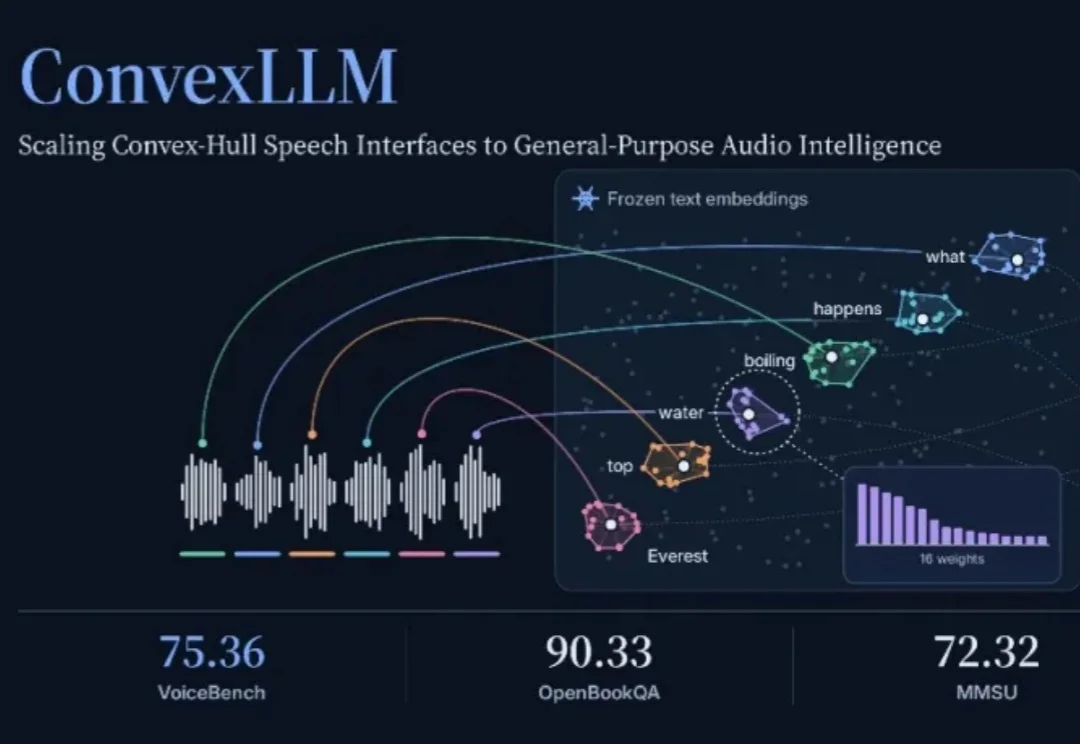
港中深联合微软研究院提出多模态统一建模新架构ConvexLLM,让声音接上大模型已经学会的知识与推理

港中深联合微软研究院提出多模态统一建模新架构ConvexLLM,让声音接上大模型已经学会的知识与推理

港中深联合微软研究院提出多模态统一建模新架构ConvexLLM,让声音接上大模型已经学会的知识与推理

此次提出的 ConvexLLM,通过创新的 C-Gate 架构,将语音信息映射至大语言模型原有文本词向量的凸包中,使模型能够充分发挥已有的知识储备与推理能力。在 VoiceBench 等多项基准测试中,ConvexLLM 取得了同量级开源模型中的领先表现,为语音与语言的统一建模提供了新的技术路径。

来自主题: AI技术研报
7719 点击    2026-11-19 08:36
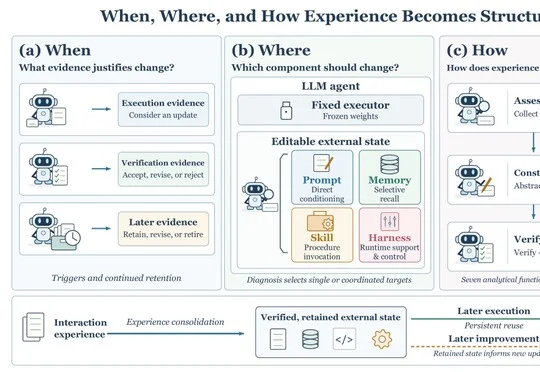
Agent如何越用越强?中科院自动化所、美团等推出RSI综述

Agent如何越用越强?中科院自动化所、美团等推出RSI综述

Agent如何越用越强?中科院自动化所、美团等推出RSI综述

中国科学院自动化研究所、美团等机构推出LLM Agent递归自我改进综述,以Prompt、Memory、Skill和Harness四条主线及When、Where、How三问、七步生命周期,梳理Agent将交互经验转化为可验证、复用且持续维护的改进机制。

来自主题: AI技术研报
9166 点击    2026-11-15 11:28
NeurIPS 2026 | 港大提出RaPO:强化微调破解MLLM灾难性遗忘,代码已开源

NeurIPS 2026 | 港大提出RaPO:强化微调破解MLLM灾难性遗忘,代码已开源

NeurIPS 2026 | 港大提出RaPO:强化微调破解MLLM灾难性遗忘,代码已开源

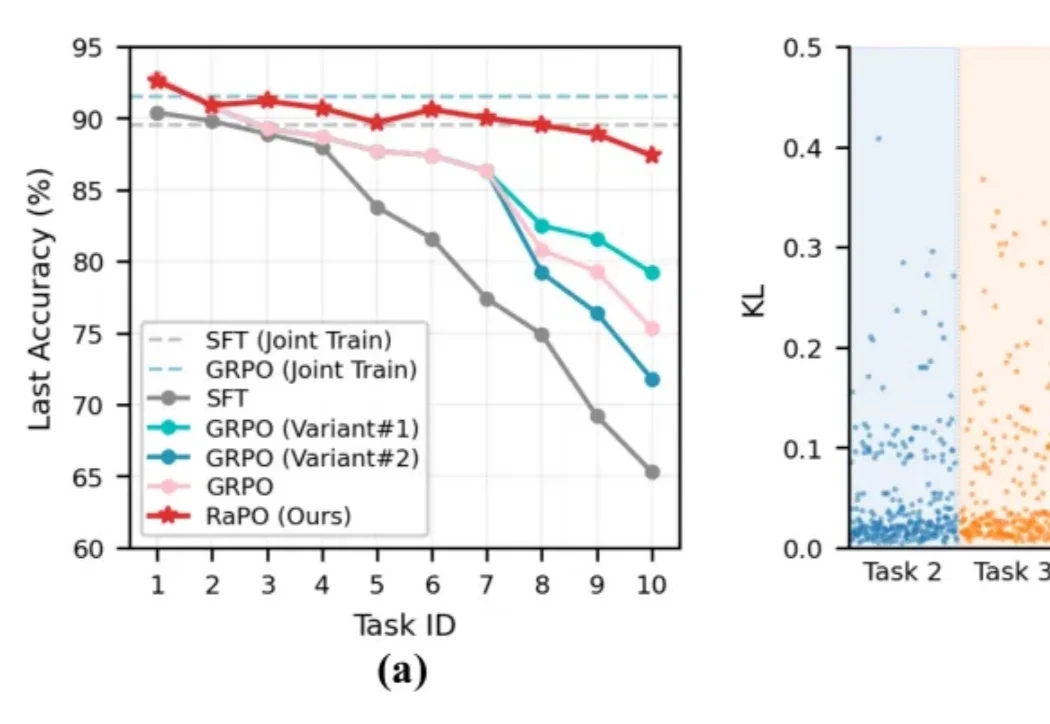
在 LLM/MLLM 领域,基于 verifier 奖励的强化微调(Reinforcement Fine-Tuning, RFT,如 GRPO)在激发复杂推理能力方面展现出显著优势。由于 On-policy 优化的特性,很多研究指出 RFT 相比传统的监督微调(SFT)天然具备更强的抗遗忘能力。

来自主题: AI技术研报
9178 点击    2026-11-05 17:01
比GPT-6 Luna快8倍!扩散LLM跑分也反超了

比GPT-6 Luna快8倍!扩散LLM跑分也反超了

比GPT-6 Luna快8倍!扩散LLM跑分也反超了

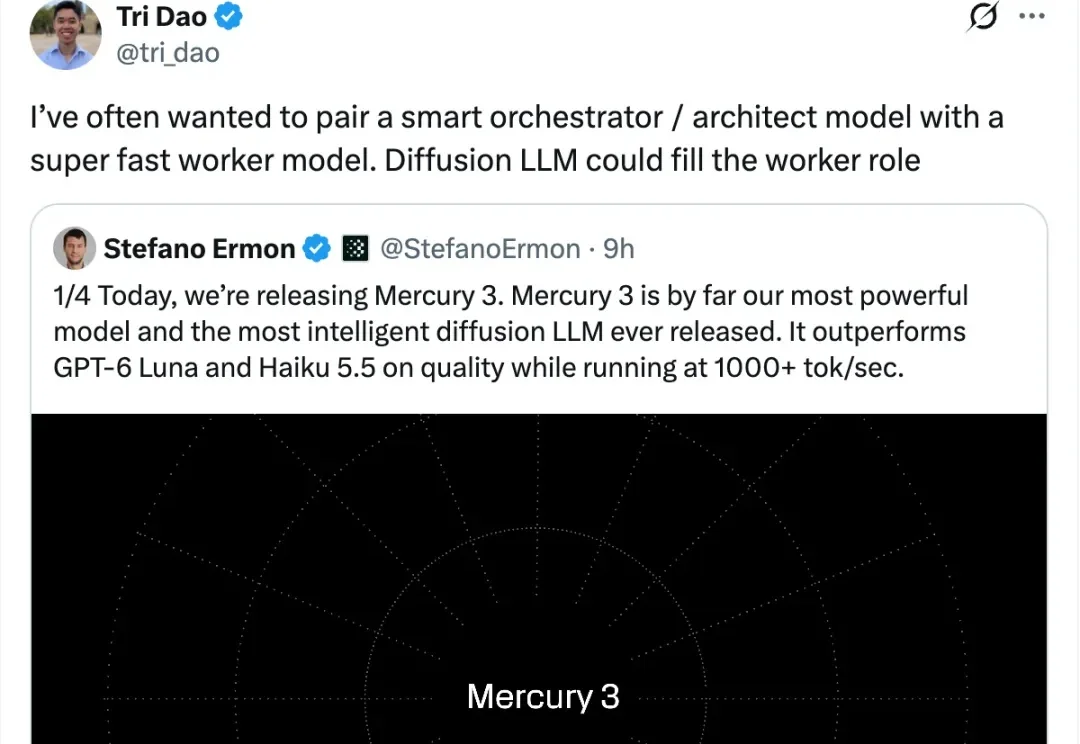
GPT-6 Luna 要被扩散 LLM 抢饭碗了?

来自主题: AI资讯
8813 点击    2026-10-26 11:13
NeurIPS 2026 | 从Token到Span:重新思考大语言模型的不确定性估计

NeurIPS 2026 | 从Token到Span:重新思考大语言模型的不确定性估计

NeurIPS 2026 | 从Token到Span:重新思考大语言模型的不确定性估计

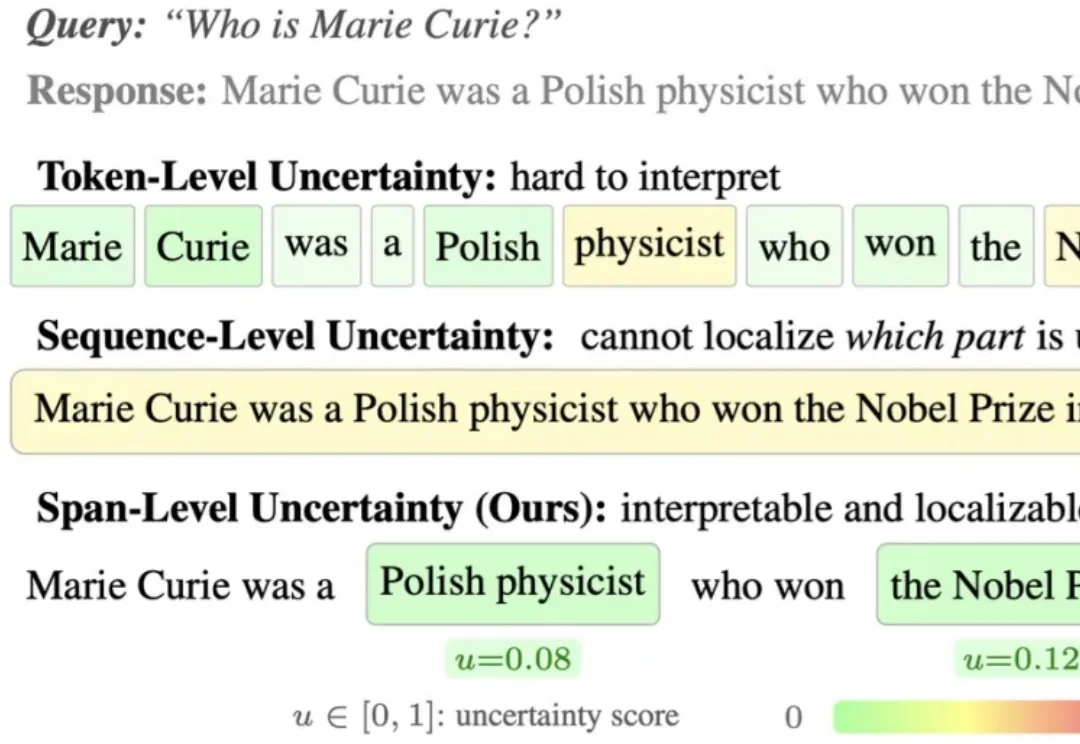
在将 LLM 真正应用到产品的过程中,我们经常会遇到一个看似简单、却非常关键的问题:模型生成的内容,究竟有多可信?

来自主题: AI技术研报
10831 点击    2026-10-23 09:58
0.6B起!Jev对手模型来了,开源多模态,登上全球测评榜一

0.6B起!Jev对手模型来了,开源多模态,登上全球测评榜一

0.6B起!Jev对手模型来了,开源多模态,登上全球测评榜一

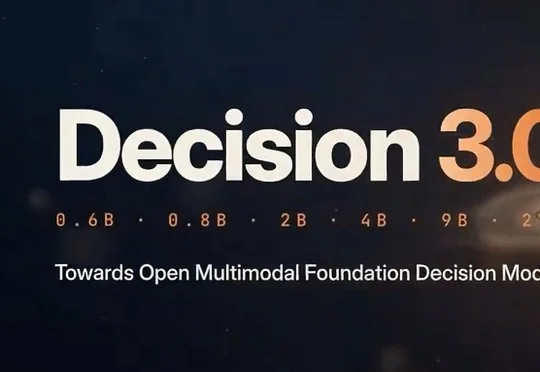
vLLM Semantic Router推出并开源Decision 3.0系列多模态决策模型,覆盖0.6B至27B六款模型,其中d3在Jev Decision Index 0.3.1文本榜和视觉榜均排名第一。

来自主题: AI资讯
10536 点击    2026-10-12 19:23
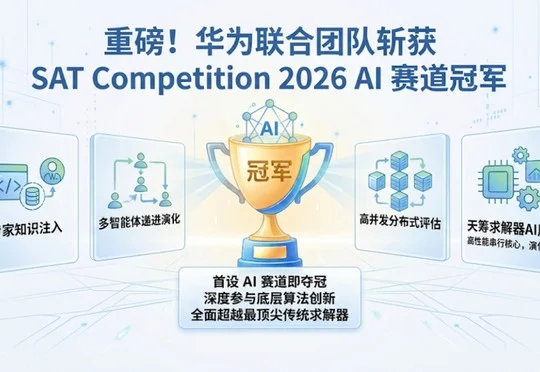
LLM For Algorithm Design,华为联合团队斩获SAT 2026大赛AI赛道冠军

LLM For Algorithm Design,华为联合团队斩获SAT 2026大赛AI赛道冠军

LLM For Algorithm Design,华为联合团队斩获SAT 2026大赛AI赛道冠军

华为诺亚方舟实验室、华为云天筹AI求解器团队与华中科技大学John Hopcroft计算中心组成的联合团队,依托华为云天筹决策智能引擎和LLM4AD_Next算法设计平台,斩获SAT Competition 2026并行AI赛道SAT组冠军。

来自主题: AI资讯
8483 点击    2026-09-29 11:10
Meshy: 角色驱动下SPMD范式的RL训练框架

Meshy: 角色驱动下SPMD范式的RL训练框架

Meshy: 角色驱动下SPMD范式的RL训练框架

在过去的几年里,LLM RL 系统的工作负载发生了巨大的变化。早期的 RLHF 围绕同步训练展开:模型按固定顺序进行生成、打分和训练,每个阶段之间有着明确的同步边界。如今,系统还需要处理异步生成、持续训练、多轮 Agent 以及与外部环境的交互 —— 那些在同步执行中原本隐含的状态、版本和故障边界,现在都必须显式地进行管理。

来自主题: AI技术研报
11056 点击    2026-09-17 10:11
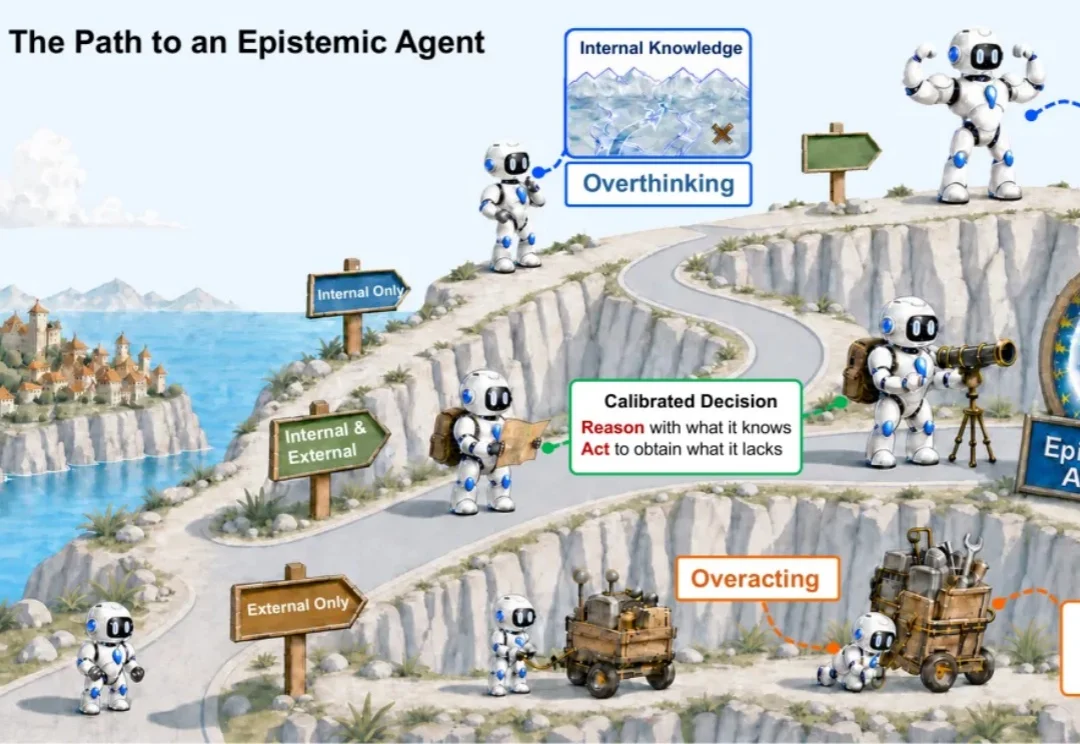
别让Agent瞎想乱搜还闯祸:哪些能力该内化进模型,哪些必须交给Harness,这篇讲透

别让Agent瞎想乱搜还闯祸:哪些能力该内化进模型,哪些必须交给Harness,这篇讲透

别让Agent瞎想乱搜还闯祸:哪些能力该内化进模型,哪些必须交给Harness,这篇讲透

北航、南方科技大学、复旦大学、北京理工大学、爱丁堡大学等 8 家机构的 19 位研究者联合完成 Theory of Agent 综述,讨论模型内部与外部 harness 应如何分配能力,并据此梳理 LLM Agent 的学习、对齐、演化与评测。

来自主题: AI技术研报
9482 点击    2026-09-16 10:07